Data Engineering Services
Ihr Fundament für verlässliche Daten, Analytics und KI
Bevor KI liefert, müssen die Daten stimmen
KI- und Analytics-Vorhaben stehen und fallen mit der Datenbasis. Wo Zahlen sich widersprechen, Plattformen halb leer bleiben und Pipelines ohne Tests laufen, hilft auch das beste Modell nicht weiter.
Wir bauen das Fundament darunter: integrierte, qualitätsgesicherte Daten, die verlässlich verfügbar sind – produktiv betrieben statt als Proof of Concept für die Schublade.
Less Technology. Better Business.
Engineering, das in Produktion ankommt
Produktiv statt Pilotprojekt
Rund 70 % unserer Engagements münden in eine produktiv betriebene Plattform – mit getestetem Code und Senior-Engineers ab Tag eins.
Architektur ohne Ballast
Unsere Medallion-Reference-Architecture trägt den Use Case mit 20–30 % weniger Komponenten – schlank, wartbar und ohne Over-Engineering.
Herstellertiefe ohne Bindung
Zertifiziert auf Snowflake, Databricks, Microsoft und AWS, aber ohne Provision – wir empfehlen, was Ihr Use Case braucht, nie die Marge.
Kosten von Beginn an
FinOps planen wir von Tag eins ein: Tagging, Right-Sizing und Alerts senken Ihre Cloud-Kosten typischerweise um 20–40 % gegenüber Standard.
Bereits während der Testphase des MVPs wurde deutlich, dass wir mit unserem Dashboard einen erheblichen Mehrwert für die Vertriebsmitarbeiter schaffen.
Data Engineering Services: das Fundament unter Analytics und KI
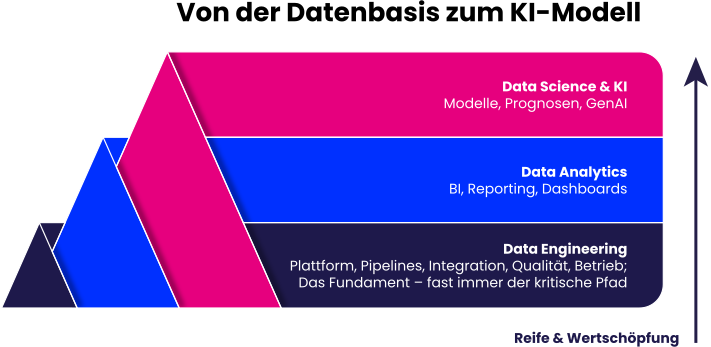
Data Engineering Services sind das Handwerk und die Infrastruktur, die Ihre Daten verlässlich verfügbar, integriert, qualitätsgesichert und nutzbar machen – Plattformen, Pipelines, Modellierung und Betrieb. Sie sind die Schicht, auf der Analytics und KI überhaupt erst tragfähig aufsetzen, und damit fast immer der kritische Pfad. Als Data Engineering Consulting bündeln wir Strategie, Architektur und Tool-Entscheidung.
Innerhalb der Data Engineering Services konzentrieren wir uns auf die Datenbasis – das Fundament. Die Modelle darauf, BI-Reporting und vollständige Governance-Programme übernehmen unsere Schwester-Teams aus Data Science, KI, Analytics und Governance Consulting, sodass Sie alles aus einer Hand bekommen. Bewusst verzichten wir nur auf eines: reine Tool-Lizenzierung und Reselling – das hält unsere Empfehlung neutral.
Data Engineering, Analytics oder Data Science – was kommt wann?
Fließen Ihre Daten nicht verlässlich, ist Data Engineering der Einstieg. Sind die Daten da, aber niemand versteht sie, übernimmt Data Analytics. Stehen Daten und Reporting und fehlen nur die Vorhersagen, kommt Data Science ins Spiel. In der Praxis laufen die drei oft parallel – die Datenbasis bleibt der kritische Pfad.
DWH-Consulting, DWH-Services und Data Integration – drei Teilleistungen
Drei Begriffe, die oft synonym benutzt werden, meinen Unterschiedliches:
- Data Warehouse Consulting: die konzeptionelle Seite – Modellierung und Architektur.
- Data Warehouse Services: die umsetzende Seite – Aufbau und Betrieb.
- Data Integration Services: der Spezialfall, Quellsysteme anzubinden und Daten zusammenzuführen.
Ob ETL oder ELT, Data Lake oder Lakehouse, Data Mesh oder Streaming – diese Begriffe ordnen wir bei Bedarf ein. In modernen Cloud- und Lakehouse-Architekturen dominiert ELT, in regulierten oder Legacy-Szenarien bleibt ETL relevant.
So bauen wir Ihre Datenplattform
Eine Datenplattform ist kein Produkt von der Stange. Wir setzen sie aus aufeinander abgestimmten Bausteinen zusammen – von der ersten Standortbestimmung bis zum laufenden Betrieb – und wählen bewusst die einfachste Architektur, die den Zweck erfüllt.
Sechs Bausteine, die ineinandergreifen
Wir liefern produktionsreife, skalierbare Plattformen statt isolierter Proof-of-Concepts. Diese sechs Bausteine greifen ineinander:
-
Strategie & Assessment: Reifegrad, Zielbild, priorisierte Roadmap mit Business Case.
-
Architektur & Design: Zielarchitektur aus Lakehouse, DWH oder Streaming, Datenmodell und Sicherheitskonzept.
-
Plattform-Aufbau: Cloud-nativ, mit Infrastructure as Code, CI/CD, Datenkatalog und Observability.
-
Pipeline-Entwicklung & Integration: heterogene Quellen, Batch und Streaming, mit eingebauten Qualitätstests.
-
Migration & Modernisierung: Legacy-DWH Richtung Cloud-Lakehouse, risikoarm und in Wellen.
-
Betrieb & Optimierung: Run, SRE-Mindset, FinOps und Performance-Tuning.
Im Tagesgeschäft arbeiten wir mit Azure und AWS, Snowflake, Databricks und Microsoft Fabric, Airflow und dbt, Kafka und Flink – die Wahl folgt Ihrem Use Case.
DWH-Modernisierung: Legacy ablösen ohne Big Bang
Oracle, Teradata oder SAS lösen wir Richtung Cloud-Lakehouse ab – Snowflake, Databricks oder Fabric. Statt eines riskanten Big Bang nutzen wir das Strangler Fig Pattern mit Parallelbetrieb: Alt- und Neusystem laufen eine Zeit lang nebeneinander, Reconciliation-Tests sichern die Datengleichheit, der Cutover erfolgt Schritt für Schritt.
Datenintegration: heterogene Quellen zuverlässig anbinden
SAP über OData, CDC und BW-Extraktion, dazu Salesforce, ServiceNow, IoT-Telemetrie und Legacy-Datenbanken: Unsere Data Integration Services binden an, was zusammengehört. Das Vorgehen ist immer gleich solide – Quell-Profiling, wo möglich CDC-First, verbindliche Schema-Contracts und ein Qualitäts-Gate, bevor Daten ins Ziel laufen.
Wann sich ein Neubau lohnt – und wann nicht
Die meisten Projekte starten aus einer von vier Lagen. KI oder GenAI ist geplant, doch die Daten sind nicht bereit – es fehlt an Qualität, Integration oder einer governed Plattform. Ein Legacy-DWH wie Oracle, Teradata oder SAS ist teuer, langsam und am Lebenszyklus-Ende.
Datensilos liefern widersprüchliche Zahlen, und das Reporting verliert an Vertrauen. Oder eine Cloud-Migration trifft auf wachsendes Datenvolumen und steigende Regulatorik – DORA, NIS2 und der EU AI Act erhöhen den Druck auf Nachvollziehbarkeit.
-
Ein Neubau lohnt sich, wenn Ihr System nachweislich am Limit ist, mehrere belastbare Use Cases anstehen oder die Datenmengen deutlich wachsen.
-
Wir raten ab, wenn das eigentliche Problem bei Datenqualität, Ownership oder Modellierung liegt, nur ein einzelner Report betroffen ist oder am Ende nur ein neues Tool gesucht wird.
Im zweiten Fall reicht oft, das Bestehende zu optimieren, einen gezielten Data Mart aufzusetzen oder einzelne Domänen schrittweise zu modernisieren.
Vom CDO bis zur Geschäftsführung
An der Entscheidung für eine Datenplattform hängen meist mehrere Rollen – mit unterschiedlichen Prioritäten. Wir holen jede mit dem Argument ab, das für sie zählt:
Schnellere, verlässliche Daten für Analytics und KI, messbar in der Time-to-Insight.
Stabilität und beherrschbare Kosten durch SRE-Mindset, Automatisierung und FinOps.
Endlich verlässliche Zahlen und Self-Service, ohne Warteschleife über die IT.
Investitionssicherheit durch klaren Business Case, ROI und Cost-of-Delay.
Vier Branchen, in denen wir zuhause sind
Wir kennen die wiederkehrenden Datenthemen und regulatorischen Hebel in jeder dieser Branchen aus eigenen Projekten. Das spart Vorlauf, weil Ihre Plattform auf erprobten Mustern startet und branchenspezifische Anforderungen von Anfang an eingeplant sind.
Energiewirtschaft & Utilities
Smart-Meter-Daten, Marktkommunikation und Zeitreihen-Verarbeitung auf KRITIS-konformen Plattformen – mit dem Rollout nach MsbG werden daraus Massen-Zeitreihen, die Performance und Governance fordern.
Typische Use Cases: Einspeise- und Lastprognosen für PV und Wind, Netzauslastungs-Analysen und Asset-Monitoring. Je höher der Anteil volatiler Erzeugung, desto stärker hängen Prognosegüte und Netzstabilität an verlässlichen Echtzeitdaten.
Produktion & Industrie
MES-, Shopfloor- und Sensordaten, OT/IT-Integration über OPC UA und MQTT, dazu Streaming und Edge-Anbindung.
Daraus entstehen konkrete Use Cases: Predictive Maintenance, OEE- und Ausschuss-Analysen, Track & Trace und der digitale Zwilling einer Anlage. Den Mehrwert bringt erst die Zusammenführung jahrelanger Maschinenhistorie mit Echtzeit-Strömen – die Basis für belastbare Vorhersagen statt isolierter Dashboards.
Versicherung
Schaden- und Vertragsdatenmodelle, Aktuariats-Datenflüsse und BCBS-239- sowie DORA-relevante Lineage – mit IFRS 17 und Solvency II steigt der Anspruch an Datenmenge und -qualität zusätzlich.
Daraus folgen Use Cases wie Betrugserkennung im Schaden, Underwriting- und Tarifierungs-Analytics und belastbare Reserve-Daten. Weil diese Daten historisch in getrennten Systemen liegen, ist ihre saubere Zusammenführung die Voraussetzung für jede dieser Auswertungen.
Automotive & Mobilität
Telematik- und Connected-Vehicle-Daten mit hohen Volumen- und Streaming-Anforderungen, zunehmend reguliert durch den EU Data Act und die DSGVO. Im Einsatz sind sie für Flottenmanagement, die Auswertung von Fahr- und ADAS-Daten in der Entwicklung und für Mobility-as-a-Service. Mit wachsender Flotte entscheidet die Architektur darüber, ob Telemetrie in Echtzeit auswertbar bleibt oder im Datenvolumen erstickt.
Im kostenlosen Erstgespräch klären wir Ihre Prioritäten – unverbindlich und konkret.
In vier Phasen zur produktiven Plattform
Datenplattformen entstehen bei uns iterativ und risikobewusst, ohne Big Bang und mit Blick auf messbare Ergebnisse. Vier klar abgegrenzte Phasen führen vom ersten Gespräch über den Proof of Value bis in den stabilen Dauerbetrieb.
Phase 1: Diagnose & Zielbild
In ein bis zwei Wochen sprechen wir mit Ihren Stakeholdern, nehmen Quellen, Bestand und Reifegrad auf und schärfen das Zielbild. Am Ende steht eine priorisierte Roadmap mit Business Case und ersten Quick Wins – ein klarer Fahrplan statt eines dicken Konzeptbergs.
Phase 2: Architektur & erster Durchstich
Im Architektur-Design (drei bis vier Wochen) legen wir Zielarchitektur, Tool-Wahl, Datenmodell sowie Sicherheits- und FinOps-Konzept fest. Der PoC führt dann eine Quelle end-to-end durch – mit Tests und Katalog, erster Durchstich meist in vier bis sechs Wochen.
Phase 3: Aufbau & Integration
Über drei bis neun Monate skalieren wir auf weitere Quellen und Domänen und migrieren Legacy in Wellen. Je nach Vorhaben arbeiten wir im Festpreis, in Time & Material, im dedizierten oder – am häufigsten – im hybriden Team, ergänzt um South-Shoring mit Senior-Steuerung.
Phase 4: Betrieb & Optimierung
Nach Go-Live und Hypercare übernehmen wir auf Wunsch den laufenden Betrieb: Run, SRE-Mindset, FinOps und Tuning, als Managed Service oder im Kundenteam. Gesteuert wird nach harten KPIs – Time-to-Insight, Pipeline-Zuverlässigkeit, Datenqualität, Cloud-Kosten und ROI.
Bei einem Versicherer sank die Time-to-Insight so von 11 auf 2 Tage, die Zuverlässigkeit stieg von rund 90 auf über 99 %, die Cloud-Kosten fielen um etwa 35 % – bei verdoppeltem Datenvolumen.
Plattformen, die in Produktion laufen
Unsere Datenplattformen laufen im Tagesbetrieb unserer Kunden – quer durch Branchen vom öffentlichen Sektor über die Energiewirtschaft bis zur Versicherung.
-
Zur ifm-ReferenzWeltweite Lieferantenbewertung mit Azure AIAI & MLCloudIndustrie 4.0Zur ifm-ReferenzWeltweite Lieferantenbewertung im Einkauf beschleunigen, statt individueller Suchstrategien mit viel Handarbeit
Zur ifm-ReferenzChatbasierter AI Assistant auf Azure OpenAI und AI Search, der ERP-Daten, Website-Infos und interne Bewertungen bündelt
Zur ifm-ReferenzMVP in 11 Wochen produktiv, neue Mitarbeitende starten ohne lange Einarbeitung, Azure AI Platform als Basis für weitere Use Cases
-
Zur WIRKSTATT ReferenzWIRKSTATT: Business Intelligence für den VertriebsaußendienstCloudData/DatenplattformenAppsZur WIRKSTATT ReferenzAggregation von internen Kundendaten & externen Daten in einer Webanwendung
Zur WIRKSTATT ReferenzDatenbündelung &-analyse mit Amazon Bedrock
Zur WIRKSTATT ReferenzIntuitive Benutzeroberfläche für Vertrieb, 88% reduzierte Vorbereitungszeit vor Kundenbesuch
-
Zur MAN ReferenzMAN – ATLAS L4. Control Center für den autonomen TruckCloudData/DatenplattformenAppsZur MAN ReferenzControl Center zur technischen Überwachung fahrerloser LKWs
Zur MAN ReferenzUX-Design, Produkt-Strategie, Datenstruktur, Fahrzeugdaten-Visualisierung
Zur MAN ReferenzÜberwachung, Fernunterstützung, Missionsabwicklung, Berichte für kommerzielle autonome Transportlösungen
-
Zur NOW ReferenzNOW: Nationale Organisation für den Wandel in der Mobilität: Aufbau eines Datawarehouse SystemsCloudData/DatenplattformenIT-Beratung & StrategieZur NOW ReferenzDatengrundlage für flächendeckende Ladeinfrastruktur in Deutschland
Zur NOW ReferenzCloud-Datawarehouse für Integration & Analyse vieler diverser Datenquellen (AWS)
Zur NOW ReferenzSolide Architektur, Single Point of Truth sichert datenbasierte Evaluierung des Ladesäulenbedarfs
-
Zur NETZSCH ReferenzNETZSCH: Entwicklung einer IoT-PlattformCloudData/DatenplattformenIoTZur NETZSCH ReferenzEinheitliche IoT-Plattform für 3 Geschäftsbereiche, Harmonisierung der bestehenden IoT-Lösungen
Zur NETZSCH ReferenzIoT-Geräteanbindung, Visualisierungssoftware für Datenauswertung, Cloud-Infrastruktur, Betrieb
Zur NETZSCH ReferenzSchnelles Testen in der Cloud-Infrastruktur, schnelle Integrierbarkeit von Anwendungsfällen wie Predictive Maintenance, Prozessoptimierungen etc.
-
Zur TÜV Nord ReferenzTÜV NORD: IT-System für SchadengutachtenData/DatenplattformenWeb & Portal-PlattformenBanken/Versicherungen/FSIZur TÜV Nord ReferenzGanzheitliches, flexibles IT-System zur Unterstützung der Sachverständigen
Zur TÜV Nord ReferenzDigitalisierung des Prüf- & Schadensprozesses von Auftragsanlage bis Faktura
Zur TÜV Nord ReferenzEffizientere Erstellung & Abrechnung von Schadengutachten & Fahrzeugbewertungen, mind. 2 Tage Zeitersparnis
-
Zur Health.exe ReferenzHealth.exe: KI-gestützte Plattform erstellt Trainingspläne für PatientenCloudData/DatenplattformenAppsZur Health.exe ReferenzKI-gestützter Service für Orthopädie- & Sportmedizin-Facharztpraxen
Zur Health.exe ReferenzCloudbasierte Webanwendung für Ärzte zur automatisierten evidenzbasierten Erstellung individuell zugeschnittener Patienten-Trainingspläne
Zur Health.exe Referenzneue Erlösquelle ohne Fixkosten, höhere Patientenbindung, KI-gestützt & leitlinienbasiert
-
Zur Siemens ReferenzSiemens: AI Demand Prediction Plattform für die industrielle ProduktionsplanungCloudData/DatenplattformenIndustrie 4.0Zur Siemens ReferenzMachine Learning für Zeitserien-Vorhersage (Timeseries Forecasting)
Zur Siemens ReferenzAutoML zur automatisierten Anpassung der Modelle an unterschiedliche Daten
Zur Siemens ReferenzEinheitliche, skalierbare Lösung, optimierte Lagerkosten, Effizienzsteigerung
-
Zur VW ReferenzVW: Digitalisierung von Produktionskennzahlen mit der App iProcessData/DatenplattformenAppsIndustrie 4.0Zur VW ReferenzAblösung analoger, fehleranfälliger Tätigkeiten durch digitale App-Lösung
Zur VW ReferenzDigital Design, Cloud-native Technologien, UX-Konzept, UI-Design, Front- & Backend
Zur VW ReferenzMehr Produktionsprozess-Transparenz, höhere Produktions-OEE, werkübergreifend
-
Zur ReferenzApple Vision Pro für StadtplanerDigital Design/UX DesignData/DatenplattformenAppsZur ReferenzImmersive 3D-Visualisierung komplexer Energiedaten in der Apple Vision Pro
Zur ReferenzAugmented Reality, Spatial Computing, 3D-Karte mit detaillierten Daten & KPIs
Zur ReferenzGrundlage für intuitive Erfassung von Energieszenarien & fundierte Entscheidungen
-
Zur ReferenzPlanungssysteme: Optimierung der Auslastung von PresswerkenData/DatenplattformenIndustrie 4.0ProduktionZur ReferenzZentrale Planung der Komponentenfertigung für kosten- & ressourcenoptimierte Produktionsauslastung weltweit
Zur ReferenzUmbau von lokaler Verarbeitung mit FatClients zur Client Sever-Anwendung, Migration in die Cloud
Zur ReferenzDatenbasierte Planung & Kalkulierung unterschiedlicher Fertigungsszenarien & standortspezifischer Herstellkosten
-
Zur ReferenzGlobales Bedarfsplanungssystem für ArbeitskräfteCloudData/DatenplattformenPublic/VerwaltungZur ReferenzZentrales webbasiertes IT-System zur Ablösung individueller Insellösungen
Zur ReferenzEvent Sourcing für Planung & Analytik, Domain Driven Design, Cloud-Migration
Zur ReferenzEinfache Updates, Erweiterung, Wartung, optimierte Sicherheit
-
Zur KUKA ReferenzKUKA: UI-/UX-Design für eine App zur Lastdatenanalyse bei IndustrieroboternDigital Design/UX DesignData/DatenplattformenAppsZur KUKA ReferenzWeb-App zur Ablösung von Legacy Systemen für einfachere Interaktion zwischen Nutzern & System
Zur KUKA ReferenzUmbau von lokaler Verarbeitung mit FatClients zur Client Sever-Anwendung & Migration in die Cloud
Zur KUKA ReferenzDatenbasierte Planung & Kalkulierung unterschiedlicher Fertigungsszenarien & standortspezifischer Herstellkosten
-
Zur ReferenzEine Datenplattform für die Azure Cloud in der EnergiebrancheCloudData/DatenplattformenIT-Beratung & StrategieZur ReferenzDatenbasierte Informationen zur Planung & Umsetzung der Klimawende für öffentlichen Sektor & Energieversorger
Zur ReferenzSkalierbare Foundation Datenplattform auf MS Azure zur Migration & Automatisierung unterschiedlich formatierter Geo-Daten in ein strukturiertes Datenschema
Zur ReferenzQualitätsgeprüfte Daten, Bereitstellung in Form des Zieldatenmodells, robuste, skalierbare Datenbank & Infrastruktur
-
Zur FinOps ReferenzLieferkettenmanagement: Senkung der Cloud-Betriebskosten um 50 Prozent durch FinOpsCloudData/DatenplattformenIT-Beratung & StrategieZur FinOps ReferenzReduzierung von Kosten durch Überdimensionierung & manuelle Abläufe, Etablierung von Transparenz
Zur FinOps ReferenzGezielte Prozessmodernisierung, Automatisierung & Rightsizing
Zur FinOps ReferenzJährliche Cloud-Betriebskostensenkung: 400.000 EUR, Skalierbarkeit, Ausfallsicherheit
In zwei Wochen wissen Sie, wo Sie stehen
Bevor Sie investieren, schaffen wir Klarheit. Unser Data Engineering Assessment liefert in rund zwei Wochen eine Bestandsaufnahme, einen Reifegrad und eine priorisierte Roadmap samt Business Case – mit minimalem Aufwand für Ihr Team. Ob die Ergebnisse in eine Umsetzung fließen oder den Bestand absichern, entscheiden Sie.
Wir sichten Datenlandschaft, Quellen, Pain Points und vorhandene Plattform.
Lakehouse, DWH oder Streaming – die Tool-Entscheidung fällt herstellerneutral anhand eines Bewertungsrasters.
Quick Wins, Cutover-Strategie und die nächsten Schritte, mit oder ohne anschließende Umsetzung.
Reden wir über Ihr Datenfundament
Ohne verlässliche, integrierte Datenbasis tragen Analytics und KI nicht – sie ist fast immer der kritische Pfad zu jedem datengetriebenen Vorhaben. Wer das Fundament sauber baut, muss Datenqualität und Migration später nicht teuer nachholen.
Genau hier setzen wir an: als Ingenieure, die produktiv betriebene Plattformen liefern – herstellerneutral, mit FinOps und einem erprobten Migrations-Playbook.
Wir bringen Ihre Datenbasis auf Data-Readiness – sprechen wir darüber, wo Sie stehen.
Häufige Fragen zu Data Engineering Services
Snowflake oder Databricks – welche Plattform passt zu uns?
Das entscheiden wir gemeinsam anhand eines Bewertungsrasters statt nach Lieblingsplattform: dominierende Use Cases, vorhandene Team-Skills, bestehendes Cloud-Setup, Datenvolumen, Latenz, Compliance und Kostenmuster. Wir sind auf beiden zertifiziert und an keine Provision gebunden – oft ist auch eine Kombination oder Microsoft Fabric die passendere Antwort.
Was kostet ein Data-Engineering-Projekt – und ab wann rechnet es sich?
Wir starten mit einem Business Case in rund zwei Wochen. Teurer als das Projekt sind meist der Cost-of-Delay und ungetunte Cloud-Kosten; eingebautes FinOps senkt die Cloud-Kosten typischerweise um 20–40 %. Abgerechnet wird je nach Vorhaben als Festpreis-Paket oder im Time-&-Material-Modell.
Können wir das nicht selbst inhouse aufbauen?
Können Sie – inhouse dauert es allerdings meist doppelt so lange. Wir bringen erprobte Templates und Hersteller-Zugang mit und übergeben die Plattform definiert, sodass Ihr Team sie anschließend eigenständig weiterführt.
Wie stellen Sie Datenschutz und Compliance der Datenpipelines sicher?
Compliance bauen wir als Gate in die Pipeline ein, nicht als nachgelagertes Audit. Dazu gehören Qualitäts-Tests mit dbt, Great Expectations und Soda, ein Data Catalog mit automatisierter Lineage, Zugriffskonzepte über RBAC und ABAC, Tag-based Masking und PII-Klassifikation sowie DSGVO-konforme Pseudonymisierung und Löschkonzepte. Data Act, NIS2 und EU AI Act denken wir von Anfang an mit.
Wie passt Data Engineering zu unserer KI-Strategie?
KI ist nur so gut wie die Daten darunter. Für GenAI müssen heute auch unstrukturierte Daten – Dokumente, Texte – nutzbar, klassifiziert und mit Lineage versehen sein. Wir planen die Plattform deshalb von Anfang an für strukturierte und unstrukturierte Daten und schaffen die Data Readiness, auf der Modelle verlässlich aufsetzen.