
MLOps: Machine Learning im Dauerbetrieb
Geschätzte Lesezeit: 7 Minuten

Viele Konzerne haben ML-Pilotprojekte am Laufen – produktiv läuft davon wenig. Aber laut einer Capgemini-Studie von 2025 pausieren schon zwei Drittel der Führungskräfte gezielt geringwertige KI-Initiativen, um produktive Use Cases zu beschleunigen. Die Studie zeigt, die Wirtschaft ist reif für den Übergang vom Experiment zur betriebsfähigen Architektur. Genau hier setzt MLOps an: als Rahmen für Daten, Modelle, Monitoring und Governance.
- Was ist MLOps? MLOps (Machine Learning & Operations) ist der technische und organisatorische Rahmen, der Machine-Learning-Modelle aus der Entwicklung in einen stabilen, skalierbaren Produktivbetrieb führt.
- Endet MLOps beim Deployment? Nein, zum Lebenszyklus gehören Datenpipelines, Modellversionierung, Monitoring, Retraining und Governance.
- Was sind die vier Grundsätze? Automatisierung, Reproduzierbarkeit, Monitoring und Governance greifen ineinander. Kein Prinzip funktioniert allein.
- Welche Drift-Typen sollten Sie kennen? Data Drift verschiebt Eingabedaten, Concept Drift ändert fachliche Zusammenhänge, Performance Drift senkt messbar die Vorhersagequalität.
- Ist eine MLOps-Plattform ein Tool? Nein, sie ist ein Architekturkonzept aus mehreren integrierten Komponenten, ob Open Source, Cloud-native oder hybrid.
MLOps verstehen – produktiver ML-Betrieb statt Toolset
MLOps steht für Machine Learning & Operations – geschrieben als Machine Learning Operations oder Machine Learning Ops. Modellentwicklung und Betrieb rücken zusammen, nicht der Betrieb von Machine Learning. Der Rahmen standardisiert die Schritte, die Machine-Learning-Modelle aus dem Notebook in einen stabilen Produktivbetrieb führen: Datenpipelines, Modellversionierung, Deployment, Monitoring, Retraining und Governance.
Drei Ebenen tragen das Modell
Wir verstehen MLOps nicht als isoliertes Toolset, sondern als Architekturthema:
- Technische Betriebsfähigkeit: automatisierte Trainings- und Deployment-Prozesse, API-Anbindung, Monitoring von Modellqualität und Datenveränderungen, kontrollierte Retraining-Zyklen.
- Realbetrieb unter Unternehmensbedingungen: wechselnde Datenqualität, neue Fachanforderungen, Skalierung über mehrere Use Cases, Sicherheits- und Compliance-Vorgaben.
- Governance als integraler Bestandteil: dokumentierte Modellhistorie, klare Verantwortung, nachvollziehbare Freigaben.
Wann wird MLOps für Sie relevant?
Nicht jedes ML-Projekt braucht von Tag eins eine vollständige MLOps-Architektur. Spätestens an einem dieser Punkte wird sie aber unverzichtbar:
- Ein Modell soll dauerhaft produktiv laufen, nicht nur als Pilot.
- Mehrere Teams arbeiten parallel an ML-Anwendungen.
- Fachbereiche erwarten verlässliche, wiederholbare Ergebnisse.
- Regulatorische Anforderungen greifen – etwa DSGVO, EU AI Act oder branchenspezifische Vorgaben.
- Modelle müssen nachvollziehbar und auditierbar sein.
- Sie nutzen ein vorgefertigtes Modell statt eines eigenen – Versionswechsel des Anbieters, Monitoring und Freigaben fallen trotzdem an.
Trifft mindestens einer dieser Punkte zu, ersetzt MLOps die manuellen Einzelprozesse durch einen steuerbaren Betriebsrahmen.
MLOps vs. DevOps, DataOps und Analytics Automation
Vier Disziplinen werden in der Praxis regelmäßig vermischt: DevOps, DataOps, Analytics Automation und MLOps. Das schafft falsche Erwartungen an Verantwortlichkeiten, Tooling und Projektumfang – und wird teuer, sobald Modelle in Produktion sind.
Das „Ops" in DevOps, DataOps und MLOps meint dabei immer dasselbe: Development & Operations, Data & Operations, Machine Learning & Operations. Entwicklung und Betrieb rücken zusammen, weil ihre Abhängigkeiten zu groß sind, um beide Seiten getrennt zu organisieren.
| Dimension | DevOps | DataOps | Analytics Automation | MLOps |
|---|---|---|---|---|
| Artefakt | Software-Code | Datenpipelines | Reports, Dashboards, Forecasts | ML-Modelle |
| Änderungs-Treiber | Code-Updates | Schema-/Quellen-Änderungen | Regel-Updates | Daten- und Modell-Drift |
| Lebenszyklus-Ende | stabiles Deployment | stabile Datenbereitstellung | wiederkehrender Lauf | kontinuierlicher Kreislauf |
| Monitoring-Fokus | App-Performance | Datenqualität | Reportverfügbarkeit | Modellqualität, Drift |
| Owner | Dev + Ops | Data Engineering + Ops | BI / Reporting | Data Science + Plattform-Engineering + Fachbereich |
Der entscheidende Unterschied: Bei DevOps bleibt die Logik nach dem Deployment stabil – bei MLOps verändert sich die Modellqualität schon, sobald sich die Daten verschieben (Continuous Training). Genau hier endet auch DataOps: bei der Datenbereitstellung. MLOps fängt dort an, wo diese Daten in Training, Inferenz und Modellbetrieb fließen. Ein funktionierendes Data Warehouse ist deshalb noch keine Grundlage für produktive ML-Systeme.
Wirkung von MLOps in der Konzern-Praxis
Aus dem PoC-Friedhof in die Werkhalle – das ist die Bewegung, die MLOps ermöglicht. Drei Effekte machen den Unterschied:
- Schneller produktiv: Manuelle Übergaben und unklare Betriebsprozesse sind die typischen Engpässe. MLOps systematisiert Training, Validierung, Deployment und Freigabe; die Reibung sinkt messbar.
- Stabiler im Betrieb: Modelle verlieren Qualität, wenn sich Daten verschieben. Monitoring erkennt Drift früh, Retraining hält die Vorhersagegüte über die Zeit.
- Skalierbar und auditierbar: Zentrale Pipelines, Model Registries und Governance-Prozesse machen aus Einzel-PoCs eine ML-Landschaft – mit dokumentierter Historie, die Audits und Compliance trägt.
MLOps schafft die operative Grundlage, auf der KI in Unternehmen überhaupt produktiv wirken kann – nicht als Pilotprojekt, sondern als Bestandteil der Wertschöpfung. Eine Untersuchung von Fraunhofer IAIS und KI.NRW bestätigt: MLOps-Investitionen rechnen sich rasch durch Effizienzgewinne, Qualitätsoptimierung und neue Produkte. Voraussetzung ist, dass Architektur und Betriebsmodell zusammenpassen. Tool-Stapelung allein bringt keinen Effekt.
Der MLOps-Lebenszyklus
Der MLOps-Lebenszyklus läuft als geschlossener Kreislauf, kein lineares Projekt mit Enddatum.
MLOps-Lebenszyklus: ein geschlossener Kreislauf
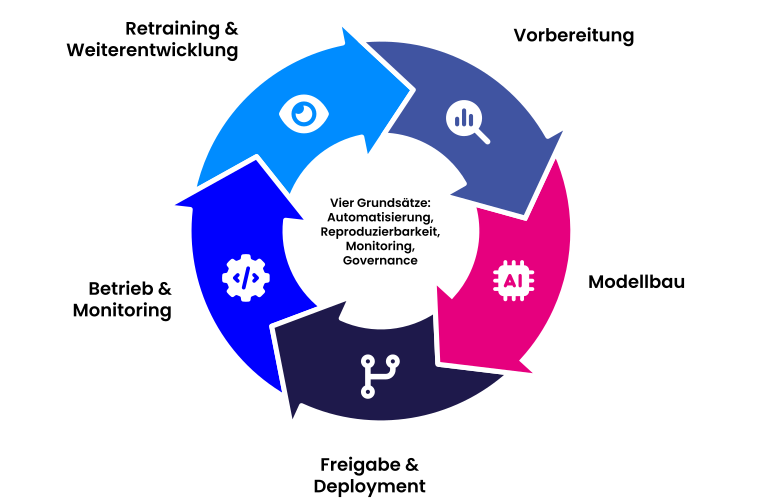
Die 5 Phasen im Überblick
- Vorbereitung: Problem klären, Datenquellen erschließen, Daten validieren, Feature Pipelines aufbauen – reproduzierbar und identisch für Training und Inferenz.
- Modellbau: Training mit Experiment Tracking und systematischer Versionierung; Validierung jenseits reiner Accuracy – Bias-Risiken, Grenzfälle und fachliche Plausibilität gehören dazu. Hier verzahnt sich MLOps eng mit klassischer Data Science, die Modellauswahl und Validierungslogik liefert.
- Freigabe und Deployment: Governance-Prüfung mit klarer Verantwortung, Rollout versionierbar und rollback-fähig, Tests unter realistischen Lastbedingungen.
- Betrieb und Monitoring: Modellqualität, Fehlerraten und Antwortzeiten überwachen – nicht nur die technische Verfügbarkeit. Hier zählt vor allem das Erkennen von Drift: Data Drift (Eingabedaten verschieben sich), Concept Drift (fachliche Zusammenhänge ändern sich) und Performance Drift (Vorhersagegüte sinkt messbar). Regelmäßige Drift-Kontrollen sind Praxis-Standard, denn Modellqualität kann sich kurzfristig verschlechtern.
- Retraining und Weiterentwicklung: kontrolliertes Retraining mit fachlicher Freigabe in regulierten Kontexten. Neue Use Cases nutzen vorhandene Plattform-Komponenten weiter, statt jedes Mal bei null zu starten.
4 Grundsätze halten den Kreislauf zusammen
Egal in welcher Phase: vier Prinzipien greifen ineinander – kein Prinzip funktioniert allein. Zusammen sind sie das, was mit „Ops" in MLOps gemeint ist.
- Automatisierung steuert wiederkehrende Abläufe.
- Reproduzierbarkeit sichert Daten-, Modell- und Parameter-Nachvollziehbarkeit.
- Monitoring kontrolliert die Modellqualität im Betrieb.
- Governance regelt Verantwortung, Freigaben und Auditierbarkeit.

MLOps-Plattform: Open Source, Cloud-native oder hybrid?
Eine MLOps-Plattform ist kein einzelnes Tool. Sie ist ein Architekturkonzept aus mehreren integrierten Komponenten: Trainings- und Pipeline-Orchestrierung, Model Registry, Deployment-Steuerung, Monitoring, Governance. AWS, Microsoft Azure und Google Cloud dominieren als drei Hyperscaler den europäischen Markt, daneben halten sich Open-Source-Stacks und spezialisierte EU-Anbieter. Welche Architektur konkret sinnvoll ist, hängt eng mit der bestehenden Cloud-Strategie zusammen.
Drei Plattform-Modelle im Vergleich
| Dimension | Open Source | Cloud-native | Hybrid |
|---|---|---|---|
| Beispiele | Kubeflow, MLflow, Airflow | SageMaker, Vertex AI, Azure ML | MLflow + SageMaker oder Vertex AI + On-Prem-Kubeflow |
| Setup-Zeit | Wochen bis Monate | Tage bis Wochen | Wochen, mit Architektur-Aufwand |
| Lock-in-Risiko | niedrig | hoch | mittel |
| Compliance-Profil | flexibel, eigenes Setup nötig | EU-Region wählbar, ISO-zertifiziert | kritische Workloads on-prem, Standard in der Cloud |
| Typische Konstellation | regulierte Branchen, eigene Cloud, vorhandenes Plattform-Engineering | Cloud-first-Strategie, schnelle Skalierung, Standard-Use-Cases | gemischte Konzern-Realität |
Welche Variante passt zu welchem Konzern?
- Cloud-native für Cloud-first-Konzerne: kurze Time-to-Pilot, Skalierung kommt integriert mit, ideal für Standard-Use-Cases.
- Open Source für eigene Cloud oder datensensible Workloads on-prem – dafür mit eigenem Plattform-Engineering-Aufwand.
- Hybrid für die gemischte Konzern-Realität: zum Beispiel MLflow als Registry, Cloud-Dienst fürs Serving, eigene Daten-Plattform plus Compliance-Layer.
Entscheidend ist die klare Architektur-Entscheidung am Anfang – Tool-Wildwuchs entsteht genau dort, wo sie fehlt.
Wo MLOps scheitert – und woran Sie Reife erkennen
Reife ist messbar, aber nicht binär. Konzerne scheitern häufig an denselben sechs Stellen. Mit dem EU AI Act, der seit August 2024 in Kraft ist, verschärfen sich die Anforderungen zusätzlich – Artikel 9 verlangt kontinuierliche Risiko-Überwachung über den gesamten KI-Lebenszyklus.
6 Stolpersteine, an denen Initiativen scheitern
- Pilot Purgatory: kein Übergang vom PoC in den Produktivbetrieb – meist nicht aus Modellgüte, sondern aus fehlender Architektur.
- Datenvalidierung erst beim Modell, nicht beim Eingang: Datenprobleme tarnen sich als Modellprobleme.
- Governance als Nachzügler: Wird sie erst bei mehreren produktiven Modellen eingeführt, fehlt die historische Nachvollziehbarkeit.
- Monitoring nur auf technischer Ebene: Modellqualitäts-Drift bleibt unbemerkt, schleichender Werteverlust folgt.
- Tool-Wildwuchs statt Plattform: Jedes Modell entwickelt einen Sonderweg, Skalierung scheitert.
- Übergaben zwischen Rollen: Data Scientists, Data Engineers, Plattform-Teams und Fachbereiche arbeiten mit unterschiedlichen Werkzeugen und Prioritäten – die meisten produktiven Probleme entstehen genau an diesen Schnittstellen.
Unsere Technologieeffizienz-Studie 2026 bestätigt das Muster auch jenseits von ML: 61 % haben 2025 den Einsatzumfang von KI-Tools erhöht – 52 % berichten parallel von zunehmend ineffizienten Software-Lösungen im eigenen Unternehmen. KI auf ungeklärte Prozesse angewendet skaliert das Falsche statt das Richtige.
4 Reifegrade: Wo steht Ihr Unternehmen?
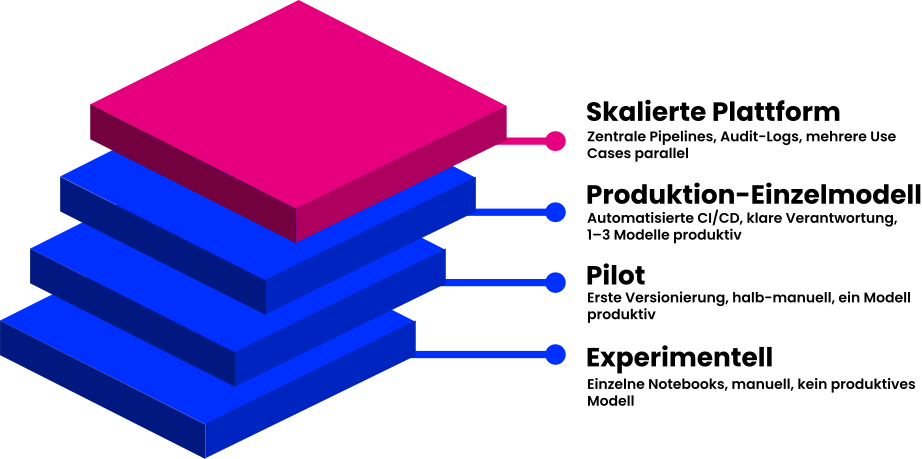
Selbst-Check: Vier Fragen zu Ihrem Reifegrad
- Welche Modellversion läuft gerade produktiv?
- Auf welchen Daten basiert sie?
- Wann wurde sie zuletzt retrainiert und freigegeben?
- Wer trägt fachliche Verantwortung für ihre Aussagen?
Wer drei dieser Fragen nicht klar beantworten kann, steht auf Reifegrad-Stufe 2 oder darunter.
MLOps mit MaibornWolff
Reifegrad-Assessment, Zielbild, Roadmap, Implementierung, Skalierung – unser Vorgehen verbindet IT-Beratung mit konkreter Umsetzung. Wir denken Daten, Modelle und Governance von Anfang an zusammen, statt Tools nachträglich zu integrieren. 35 Jahre Konzern-Erfahrung, ISO-9001-, ISO-27001- und TISAX-Zertifizierungen sowie strategische Partnerschaften mit AWS, Microsoft und StackIT bilden den Rahmen.
Less Technology. Better Business.
Häufige Fragen zu MLOps
Wie passt MLOps zu DSGVO, ISO 27001 und TISAX?
DSGVO Artikel 32 verlangt dokumentierte Datenherkunft und Verschlüsselung. ISO 27001 fordert RBAC, Verschlüsselung und Audit-Logs über mindestens zwölf Monate. TISAX ergänzt automotive-spezifische Zutritts- und Lieferkettenanforderungen. MLOps-Plattformen erfüllen das, wenn EU-Datenstandort und Audit-Pipelines von Anfang an Teil der Architektur sind – ein Bereich, in dem MLOps und Cybersecurity zwingend zusammengedacht werden müssen.
Wie erkennt man Data, Concept und Performance Drift im Betrieb?
Data Drift wird über statistische Vergleiche der Eingabeverteilungen erkannt – etwa per Kolmogorov-Smirnov-Test oder Population Stability Index. Concept Drift zeigt sich oft erst, wenn die Vorhersagegüte fällt; gezielte Plausibilitätsprüfungen helfen, ihn früher zu sehen. Performance Drift wird über kontinuierliches Tracking von Genauigkeit, Business-Metriken und Fehlerraten mit definierten Schwellen sichtbar. Regelmäßige Drift-Kontrollen – je nach Use Case wöchentlich oder monatlich – sind Praxis-Standard.
Wie misst man den Erfolg eines MLOps-Ansatzes?
Drei Indikatoren tragen die Bewertung: Time-to-Production (Reduktion von der Modellidee bis zum produktiven Einsatz), Stabilität (dokumentierte Modellhistorie, Audit-Fähigkeit, weniger ungeplante Ausfälle) und Business-Impact (messbare Wirkung auf Geschäfts-KPIs, nicht nur Modell-Accuracy).
Vadim gestaltet als Berater und Software-Designer die Lösungen der Delivery Unit „Pro-Code AI Solutions“ aktiv mit. Mit einem Background in Digital Design und Process Usability fokussiert er sich darauf, Geschäfts- und Produktionsprozesse messbar besser zu machen. In Kundenprojekten sorgt er dafür, dass neue Lösungen sich leicht, intuitiv und ohne Reibungsverluste in das bestehende Unternehmensökosystem einfügen.