
Was sind Datensilos? Definition, Ursachen und Lösungen
Geschätzte Lesezeit: 10 Minuten

Ihre Daten sind da – sie sitzen nur alle hinter dicken Wänden und kommen nicht zueinander. Das eine ist im CRM eingemauert, das andere im ERP, ein drittes in der Insellösung, die sich vor Jahren mal jemand angeschafft hat. Für jede Auswertung müssen Sie erst eine Luke nach der anderen öffnen: zusammensuchen, abgleichen, säubern. Diese abgeschotteten Datenbestände heißen Datensilos – und sie sind einer der häufigsten Gründe, warum digitale Projekte und KI-Vorhaben im Sand verlaufen.
Der Name führt es schon vor Augen: Wie ein Getreidesilo ist ein Datensilo ein hermetisch geschlossener Turm – der Inhalt ist wertvoll und reichlich vorhanden, aber jeder Silo steht für sich, erreichbar nur über eine einzige Luke. Die Daten sind also da, bleiben aber hinter ihren Wänden gefangen.
Die gute Nachricht: Ein Datensilo ist selten ein Problem von zu wenig Daten. Es ist ein Struktur- und Organisationsproblem – und das lässt sich lösen. Dieser Ratgeber zeigt Ihnen, was Datensilos sind, wie sie entstehen, warum sie teurer sind, als in jedem Budget steht, und wie Sie die Mauern Stein für Stein wieder abtragen.
Das Wichtigste in Kürze
- Was ist ein Datensilo? Ein Datensilo ist ein Datenbestand, der in einer Anwendung, Plattform oder Abteilung eingeschlossen ist und nicht transparent, portierbar und systemübergreifend nutzbar bereitsteht.
- Wie entstehen Datensilos? Vor allem durch historisch gewachsene Legacy-Systeme, Multi-Cloud-Fragmentierung, redundante Software sowie fehlende Governance und unklare Zuständigkeiten.
- Warum sind Datensilos ein Problem? Sie kosten Zeit und Geld: Ein Großteil der Projektarbeit fließt in Datenaufbereitung statt in Wertschöpfung, Prozesse verlangsamen sich, Entscheidungen beruhen auf widersprüchlichen Zahlen.
- Was hat das mit KI zu tun? KI-Fähigkeit hängt nicht von der Datenmenge ab, sondern von der Datenkohärenz. Datensilos sind die eigentliche Obergrenze für die Skalierung von KI.
- Wie löst man Datensilos auf? Durch sichtbar machen, Priorisieren nach realer Datenverfügbarkeit, Integration vor neuen Tools, klare Governance sowie Portabilität – nicht durch ein einzelnes Werkzeug.
Was sind Datensilos? Eine Definition
Ein Datensilo ist ein Datenbestand, der innerhalb einer einzelnen Anwendung, Plattform oder Organisationseinheit eingeschlossen ist – ohne Transparenz über die Datenflüsse, ohne standardisierten Zugriff und ohne Portabilität. Es ist, im Bild des Silos gesprochen, der volle, aber verschlossene Turm: Die Daten sind vorhanden, bleiben aber in technischen, organisatorischen oder plattformbedingten Grenzen gefangen.
Entscheidend ist der Perspektivwechsel: Ein Datensilo definiert sich nicht darüber, dass Daten fehlen, sondern darüber, dass ihre Transparenz, Portabilität und kontrollierte Nutzbarkeit eingeschränkt sind. Ein Datensilo ist damit weniger ein Speicherproblem als ein Nutzbarkeitsproblem – volle Regale nützen wenig, wenn die Tür klemmt.
Wichtig zur Abgrenzung: verwandte Begriffe
Nicht jede verteilte Datenlandschaft ist dasselbe. Diese Abgrenzung hilft bei der Einordnung:
| Begriff | Kurzdefinition |
|---|---|
| Isoliertes Datensilo | Daten liegen abgeschottet in einer Anwendung oder Einheit – ohne Transparenz, Standardzugriff oder Portabilität. |
| Fragmentierte Datenarchitektur | Daten sind über mehrere Systeme verteilt und nur teilweise integriert; Austausch ist möglich, aber aufwendig und fehleranfällig. |
| Redundante Applikationslandschaft | Mehrere funktional ähnliche Tools erzeugen parallele Datenbestände und widersprüchliche Sichten auf denselben Sachverhalt. |
| Plattformgebundener Datenraum | Daten sind zugänglich, aber durch proprietäre Formate oder fehlende Exit-Fähigkeit kaum aus der Plattform herauslösbar. |
| Integriert, aber unbrauchbar | Daten sind technisch zusammengeführt, aber ohne klare Semantik, Ownership und Governance nicht belastbar nutzbar. |
Wie entstehen Datensilos? Die fünf häufigsten Ursachen
Datensilos sind selten das Ergebnis einer einzelnen Fehlentscheidung. Sie wachsen über Jahre heran wie Kalk in der Leitung – unauffällig, Schicht für Schicht, bis irgendwann kaum noch etwas durchfließt. Fünf Ursachen treten dabei besonders häufig auf, technisch, organisatorisch und strategisch zugleich.
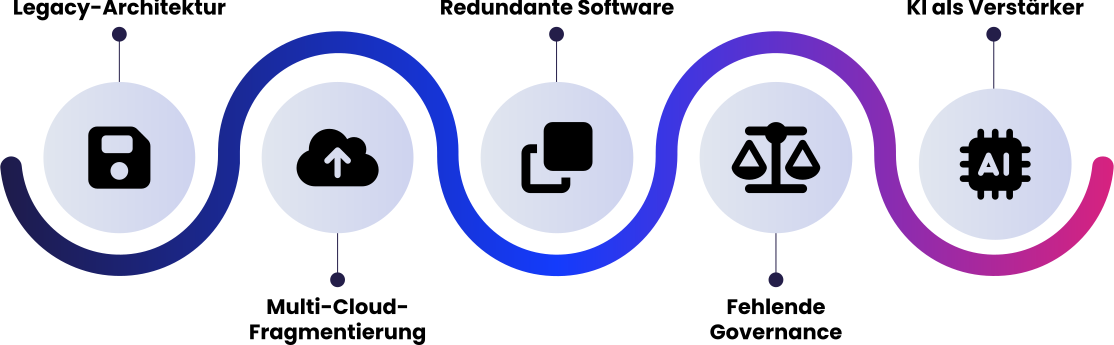
1. Legacy-Architektur und gewachsene Komplexität
Historisch gewachsene Systeme sind der Klassiker unter den Silo-Ursachen. Monolithische Legacy-Anwendungen sind schwer wartbar, teuer und störrisch wie ein alter Dieselmotor: Sie laufen, aber jede Änderung wird zur Operation am offenen Herzen. Neue Datenanforderungen werden in bestehende Inselstrukturen hineingeflickt, statt auf einer sauberen Basis aufzusetzen. Laut der Lünendonk-Studie „Digitale Souveränität“ bewerten 65 Prozent der Unternehmen ihre IT-Landschaft als sehr komplex; im MaibornWolff Report Technologieeffizienz 2026 berichten 61 Prozent, dass zu komplexe Software ihre Produktivität senkt.
2. Multi-Cloud- und Plattformfragmentierung
Der Umzug in die Cloud räumt Datensilos nicht automatisch weg – er kann den Umzugskarton nur an einen neuen Ort tragen. Werden Anwendungen, Daten und Zuständigkeiten über mehrere Anbieter und Betriebsmodelle verteilt, entstehen frische Bruchstellen in Datenflüssen und Sicherheitsmodellen. Die Lünendonk-Studie zeigt: 42 Prozent der Unternehmen nutzen bereits Multi-Cloud, weitere 46 Prozent planen den Aufbau – und mit jeder zusätzlichen Plattform steigt der Integrationsaufwand.
3. Redundante Software und Doppelstrukturen
Wenn jede Abteilung ihr Lieblingswerkzeug pflegt, bekommt am Ende jeder seine eigene Version der Wahrheit. Es entstehen parallele Datenbestände, doppelte Pflege und Zahlen, die sich im Meeting gegenseitig widersprechen. Im MaibornWolff Report Technologieeffizienz 2026 berichten 41 Prozent von redundanter Software neben funktional vergleichbaren Lösungen. Was nach gesunder „Toolvielfalt“ aussieht, ist operativ oft ein Nebeneinander konkurrierender Datenrealitäten.
4. Fehlende Governance, Transparenz und Ownership
Datensilos halten sich auch deshalb so hartnäckig, weil oft niemand so genau sagen kann, wem welche Daten eigentlich gehören. Ohne klare Zugriffsrechte, Transparenz über Datenflüsse und definierte Zuständigkeiten sind Daten zwar vorhanden, aber führerlos – wie ein Lager ohne Inventarliste. Bezeichnend: Laut MaibornWolff Report Technologieeffizienz 2026 haben nur 48 Prozent der Unternehmen definierte Kennzahlen, um den Nutzen ihrer Software überhaupt zu messen.
5. KI als Verstärker bestehender Silos
KI auf eine unaufgeräumte Datenlandschaft loszulassen, ist wie ein Turbo auf einen Motor mit verstopften Leitungen: Es wird lauter, nicht schneller. Werden neue KI-Tools eingeführt, bevor Datenstrukturen und Zuständigkeiten geklärt sind, entsteht keine kohärente KI-Architektur, sondern eine weitere Schicht Spezialwerkzeuge mit eigenen Datenzugriffen. Passend dazu befürchten laut MaibornWolff Report Technologieeffizienz 2026 rund 59 Prozent, dass „digitaler Müll“ wie redundante Daten und überflüssige Artefakte durch KI weiter zunimmt.

Unser Praxis-Guide zeigt IT-Verantwortlichen konkret, wie Sie Datensilos in Ihrer Landschaft aufspüren, bewerten und Schritt für Schritt auflösen – mit Checklisten und Vorgehensmodell.
Warum Datensilos zum Problem werden: Folgen und Kosten
Datensilos bleiben selten folgenlos – sie ziehen eine Rechnung nach sich, die nur nirgends offen ausgewiesen wird. Ihre Wirkung reicht von zähen Prozessen über verdeckte Kosten bis zu Innovationsvorhaben, die nie den Boden verlassen. Drei Ebenen sind besonders relevant.
| Ebene | Konkrete Folge |
|---|---|
| Operativ | Ein Großteil der Projektzeit fließt in Datensuche, -aufbereitung und die manuelle Überbrückung von Systembrüchen – laut Branchenkonsens und Anbietern wie AWS 60 bis 80 Prozent des Aufwands in AI/ML-Projekten. |
| Wirtschaftlich | Doppelte Datenhaltung, mehrfache Pflege und Integrationsaufwand erzeugen laufende Kosten, die in klassischen Budgets oft gar nicht separat sichtbar werden. |
| Strategisch | Widersprüchliche Datenstände untergraben belastbare Entscheidungen und verhindern eine verlässliche 360-Grad-Sicht auf Kunden, Prozesse oder Produkte. |
Besonders unbarmherzig wird der Effekt bei KI-Projekten. Studienübergreifend scheitert ein sehr hoher Anteil der KI-Vorhaben am Sprung vom Piloten in den Produktivbetrieb – Gartner (2024) beziffert die Quote der Projekte, die nie in Produktion gehen, auf rund 87 Prozent, MIT Sloan (2025) sieht 95 Prozent der Enterprise-Pilots nicht skalieren. Der Grund liegt selten im Modell, sondern in unverbundenen Datenräumen. Man kann den besten Rennfahrer engagieren – wenn die Strecke aus lauter Sackgassen besteht, kommt er trotzdem nicht ins Ziel.
Datensilos und KI: Warum mehr Daten nicht mehr KI-Fähigkeit bedeuten
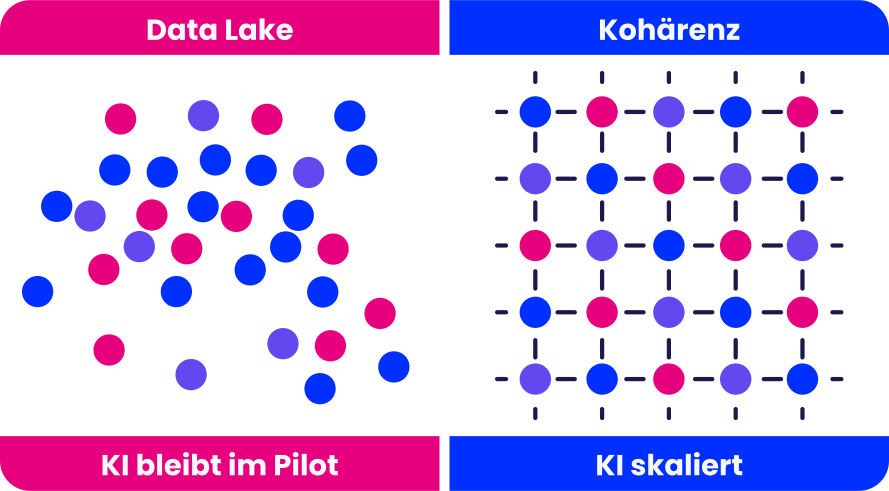
Viele Unternehmen verwechseln Datenmenge mit Datenfähigkeit – nach dem Motto: Wer genug Heu hat, findet auch die Nadel. Ein großer Data Lake oder ein Stapel neuer KI-Tools garantiert aber keine produktive Nutzung. Es gilt das eiserne Prinzip „Garbage in, garbage out“: Sind Daten lückenhaft, veraltet oder widersprüchlich, erbt das KI-Modell diese Schwächen und serviert sie mit voller Überzeugung zurück.
Damit verschiebt sich die entscheidende Frage von „Haben wir genug Daten?“ zu „Sind unsere Daten so organisiert, dass man ihnen trauen kann?“. KI-Fähigkeit hängt nicht an der Datenquantität, sondern an der Datenkohärenz – daran, ob Daten über Systemgrenzen hinweg anschlussfähig, portierbar und steuerbar sind. Genau hier zieht das Datensilo die rote Linie: Es ist die eigentliche Obergrenze der KI-Skalierung.
Datensilos zeigen sich je nach Branche unterschiedlich
Das Grundmuster ist branchenübergreifend gleich, doch Priorität und Risiko verschieben sich je nach Kontext. Drei Beispiele mit vertiefenden Branchen-Reports:
Manufacturing
In der Fertigung treffen Datensilos auf gewachsene Prozess- und Systemlandschaften sowie auf Brüche zwischen OT und IT. Daten aus Planung, Betrieb, Qualität und Service lassen sich oft nur eingeschränkt zusammenführen – das bremst die Reaktionsfähigkeit in Produktion, Supply Chain und Instandhaltung.

Der Branchen-Report zeigt, wo Datensilos in Manufacturing-Umgebungen konkret entstehen und welche Ansätze die Datenkontinuität über die vernetzte Wertschöpfung hinweg sichern.
Energy
In der Energieversorgung sind Datensilos besonders kritisch, weil Resilienz, Nachvollziehbarkeit und kontrollierte Datenflüsse einen hohen Stellenwert haben. Als kritische Infrastruktur sind Energieversorger auf beherrschbare Komplexität und steuerbare Abhängigkeiten angewiesen – Datensilos gefährden hier Betriebsfähigkeit und Modernisierungstempo.

Der Branchen-Report beleuchtet, wie Datensilos in Energie-Umgebungen Resilienz und Steuerbarkeit beeinflussen – und welche Wege zu kontrollierten, nachvollziehbaren Datenflüssen führen.
Financial Services
Banken und Versicherungen sind traditionell stark segmentiert – regulatorische Anforderungen erzwingen teils doppelgleisige Systeme. Datensilos verschärfen hier vor allem Governance-Themen: inkonsistente Kundensichten, redundante Datenhaltung und erschwerte Steuerung von Zugriffsrechten und Datenlokalisation.

Der Branchen-Report zeigt, wie Datensilos in Banken und Versicherungen Governance, Nachweisbarkeit und konsistente Kundensichten erschweren – und wie sich Durchgängigkeit herstellen lässt.
Datensilos auflösen: Lösungsansätze im Überblick
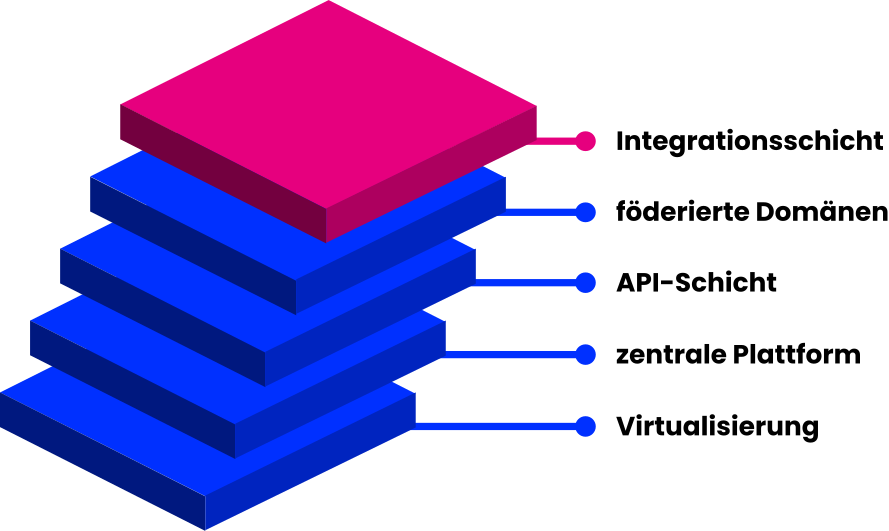
Kein einzelnes Tool löst Datensilos allein. Ob ein Ansatz trägt, entscheidet sich daran, ob er Transparenz über Datenflüsse schafft, Integrationsaufwand senkt, Portabilität ermöglicht und organisatorisch tragfähig ist. Fünf Architekturansätze werden in der Praxis am häufigsten diskutiert:
| Ansatz | Grundidee | Geeignet vor allem für |
|---|---|---|
| Integrationsschicht / Orchestrierung | Verteilte Quellen werden über gemeinsame Standards, Metadaten und Zugriffslogiken verbunden. | Heterogene Landschaften mit hohem Integrationsdruck. |
| Föderierte Domänenverantwortung | Fach- und Produktdomänen verantworten ihre Daten näher an der Wertschöpfung. | Organisationen mit reifen Domänen und belastbarer Governance. |
| API- und Zugriffsschicht | Bestehende Systeme werden über definierte Zugriffspunkte schrittweise geöffnet. | Legacy-Umgebungen mit Bedarf an schneller Entkopplung. |
| Zentrale Plattform | Daten, Analyse und Betrieb werden auf einer Plattform konsolidiert. | Starker Tool-Wildwuchs und Konsolidierungsbedarf. |
| Föderierte Abfrage / Virtualisierung | Daten bleiben am Ursprungsort und werden logisch zusammengeführt. | Kontexte mit Datenresidenz- oder Schutzanforderungen. |
Es gibt also keine universell überlegene Zielarchitektur. Maßgeblich ist, ob eine Lösung Datensilos real abbaut oder nur technisch umetikettiert – und ob sie Integrationsaufwand senkt, Transparenz erhöht und Lock-in-Risiken begrenzt. Für den dezentralen Weg über eigenständige Datenprodukte je Domäne ist Data Mesh der etablierte Ansatz. Wie eine konsolidierte Datenplattform verstreute Bestände in ein strukturiertes Schema überführt, zeigt unser Projekt für digikoo.
Schritt für Schritt: So gehen Sie Datensilos an
Der Abbau von Datensilos ist kein reines Technikprojekt, sondern ein schrittweiser Architektur-, Daten- und Organisationsansatz. Fünf Schritte haben sich bewährt:
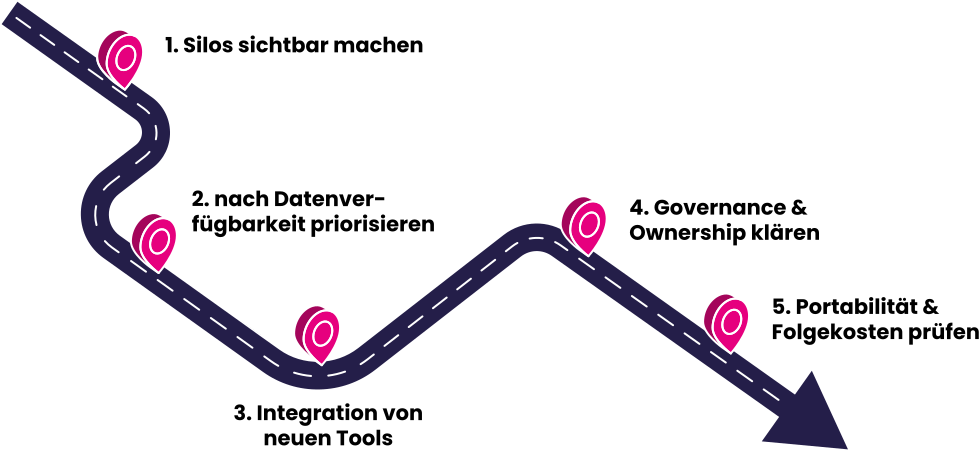
- Silos sichtbar machen. Verschaffen Sie sich Transparenz über Datenquellen, Systeme und Brüche: Wo entstehen Medienbrüche, doppelte Datenhaltung und unklare Zuständigkeiten?
- Nach realer Datenverfügbarkeit priorisieren. Ein fachlich attraktiver Use Case gehört nur dann nach oben, wenn Datenquellen anschlussfähig, Zugriffsrechte geklärt und Integrationsaufwände beherrschbar sind.
- Integration vor neuen Tools. Stärken Sie zuerst die Anschlussfähigkeit bestehender Systeme, statt eine weitere Schicht über unverbundene Altsysteme zu legen.
- Governance und Ownership klären. Definieren Sie Verantwortlichkeiten, Datenstandards und Zugriffsregeln – ohne klare Ownership werden Silos nur lokal überbrückt, nicht abgebaut.
- Portabilität und Folgekosten mitdenken. Prüfen Sie bei jeder Plattformentscheidung, ob neue Abhängigkeiten oder Lock-ins entstehen, die künftige Datenmigration und KI-Erweiterung erschweren.
Fazit: Datensilos sind eine Architektur-, keine Datenfrage
Datensilos sind weniger ein Daten- als ein Architektur- und Organisationsproblem. Fragmentierte Systemlandschaften, fehlende Transparenz, redundante Software und unklare Zuständigkeiten machen aus eigentlich wertvollen Daten schwer nutzbare Assets. Wer Datensilos reduziert, arbeitet damit zugleich an Technologieeffizienz und digitaler Souveränität – und schafft die Grundlage, auf der KI-Anwendungen zuverlässig skalieren.
Genau hier setzen wir an. Mit unserer Datenarchitektur-Beratung hilft MaibornWolff Ihnen, Datensilos ehrlich zu bewerten und gezielt einzureißen – herstellerunabhängig und ohne Selbstzweck. Wir empfehlen die Architektur, die Ihre Silos wirklich reduziert, nicht die mit der größten Rechnung. Wie das in unser gesamtes Data-&-AI-Angebot eingebettet ist, zeigt die Themenseite. Weniger Mauern, mehr nutzbare Daten: Less Technology. Better Business.
Lassen Sie uns gemeinsam herausfinden, wo Datensilos Ihre Projekte bremsen – und wie Sie eine tragfähige, KI-fähige Datenbasis schaffen.
FAQ: Häufige Fragen zu Datensilos
Was ist ein Datensilo einfach erklärt?
Ein Datensilo ist ein Datenbestand, der in einem einzelnen System oder einer Abteilung eingeschlossen ist und sich nicht ohne Weiteres mit anderen Daten verbinden lässt. Die Daten sind vorhanden, aber nicht frei nutzbar – vergleichbar mit Informationen, die in einem verschlossenen Raum liegen, zu dem nur wenige einen Schlüssel haben.
Was ist der Unterschied zwischen einem Datensilo und einem Data Lake?
Ein Data Lake ist ein bewusst angelegter, zentraler Speicher für große Mengen unterschiedlicher Daten. Ein Datensilo hingegen ist eine ungewollte Abschottung: Daten bleiben in einem System gefangen. Wichtig: Auch ein Data Lake kann zum Silo werden, wenn der Zugriff, die Semantik oder die Governance fehlen, um die Daten wirklich nutzbar zu machen.
Warum sind Datensilos für KI ein Problem?
KI-Modelle brauchen konsistente, über Systemgrenzen hinweg zugängliche Daten. Datensilos unterbrechen genau das: Sie erzwingen manuelle Datenaufbereitung, erzeugen widersprüchliche Datenstände und verhindern so, dass KI-Anwendungen vom Piloten in den stabilen Produktivbetrieb skalieren.
Wie erkenne ich Datensilos in meinem Unternehmen?
Typische Anzeichen sind: Daten müssen für Auswertungen manuell aus mehreren Systemen zusammengetragen werden, verschiedene Abteilungen nennen unterschiedliche Zahlen zum selben Sachverhalt, und niemand ist eindeutig für einen Datenbestand verantwortlich. Auch ein hoher Zeitanteil für Datensuche und -aufbereitung ist ein klares Signal.
Löst die Cloud Datensilos automatisch auf?
Nein. Eine Cloud-Migration allein beseitigt keine Datensilos und kann in Multi-Cloud-Umgebungen sogar neue schaffen. Erst wenn Datenflüsse standardisiert, Schnittstellen konsistent und Portabilität sowie Governance aktiv gestaltet werden, führt die Cloud zu besser nutzbaren Daten.
Alexander Röckl ist Head of Data & Analytics bei MaibornWolff. Der Data-&-AI-Experte ist darauf spezialisiert, tragfähige Daten- und KI-Strategien zu entwickeln und in skalierbare Lösungen zu überführen. Er begleitet Organisationen beim Aufbau moderner Datenplattformen, Governance-Strukturen und datengetriebener Produkte – von der Identifikation relevanter Use Cases bis zur technischen Umsetzung.